フィジカルAIを支える強化学習とは?ロボット制御・自動運転を実現する仕組みと大規模GPUの関係
ロボット制御や自動運転など、物理世界で動くAI、いわゆる「フィジカルAI」の進化を支えているのが「強化学習」です。人が正解を教えるのではなく、AI自身が試行錯誤を通じて最適な行動を学んでいくこの手法は、仮想空間で学習して実世界へ転移する「Sim-to-Real」と組み合わさることで、社会への実装が進んでいます。
本記事では、強化学習の基本的な仕組みとほかの機械学習手法との違い、Sim-to-Realとの関係、そして膨大な試行錯誤を支える計算リソースの考え方と環境選択のポイントまでを整理します。
本記事は、フィジカルAIの開発とそれを支える基盤技術を解説するシリーズ記事の一つです。ほかの記事もあわせてぜひご覧ください。
- フィジカルAIとは?開発の課題と基盤選定の考え方を解説
- デジタルツインとは?Sim-to-RealによるAIモデル学習の仕組みと構築5ステップを解説
- マルチモーダルAIとフィジカルAI:センサーフュージョンの基盤要件
- 強化学習とは
- 強化学習とSim-to-Real:フィジカルAIを実現する組み合わせ
- なぜ強化学習には仮想空間が必要か
- Sim-to-Realで実世界に転移する
- フィジカルAI開発における「強化学習×Sim-to-Real」
- 強化学習に必要な計算リソースと大規模GPU環境の重要性
- 試行錯誤の規模=計算量
- 実験サイクルを何度も回すという特性
- 高火力シリーズを用いた強化学習環境の構築
- フェーズで変わる計算リソースの要件
- PoC・アルゴリズム検証:高火力 DOK
- 大規模学習:高火力 PHY
- スポット学習・推論:高火力 VRT
- まとめ
強化学習とは
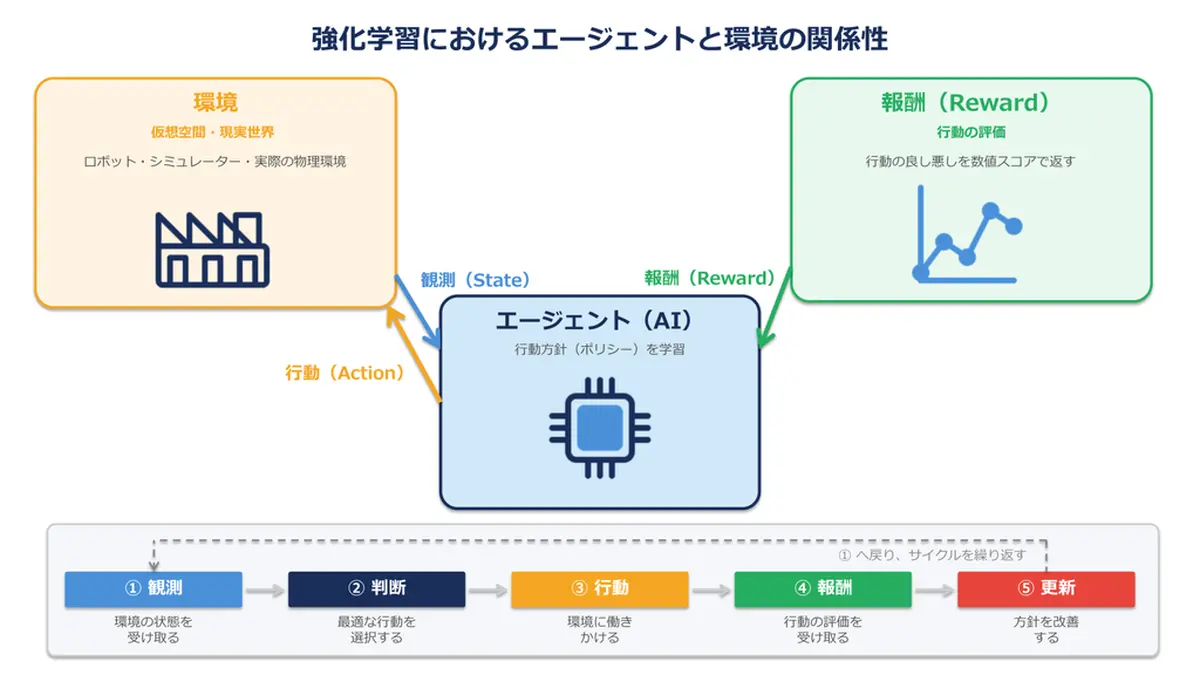
強化学習とは、エージェントが環境の状態を観察して行動を選択し、その結果として得られる「報酬」をもとに、獲得できる報酬が最大になる行動方針を試行錯誤で学んでいく機械学習手法です。
「状態を観察する→行動する→報酬を受け取る→方針を更新する」というループを何万回、何十万回と繰り返すことで、AIはしだいに賢い行動を獲得していきます。たとえばロボットの歩行学習であれば、「転ばずに前へ進めたら報酬」という基準を与え、何万回と足の踏み出し方を変えながらシミュレーションすることで、もっとも報酬の高い歩き方をAIが自ら見つけ出していきます。
強化学習とSim-to-Real:フィジカルAIを実現する組み合わせ
次に、強化学習がフィジカルAI開発の現場でどのように使われるのかを、Sim-to-Realとの関係から見ていきます。
なぜ強化学習には仮想空間が必要か
強化学習は「失敗を繰り返して学ぶ」手法です。これを最初から実機でおこなうと、転倒や衝突による機材の破損、周囲の安全リスク、そして膨大な時間やコストの発生が避けられません。
そこで活用されるのが、物理法則を再現した仮想空間上でのシミュレーションです。仮想空間上であれば、失敗しても壊れるものはなく、実時間より高速に試行できます。近年はGPUを利用して数百・数千の環境を同時に走らせる並列シミュレーション技術も普及しており、実機では不可能な規模とスピードで試行錯誤を回せます。
Sim-to-Realで実世界に転移する
仮想空間で学んだ成果を実機に転移する手法として知られるのが「Sim-to-Real」です。Sim-to-Realにより、仮想空間での強化学習の成果を、実世界のロボット制御や自動運転に活用できるようになります。
ただし、実際の転移では、仮想と現実のわずかな差が精度低下の原因になるため、仮想空間の条件をあえてばらつかせて学習するなどの工夫と組み合わせるのが一般的です。こうしたSim-to-Realの仕組みは、以下の記事でくわしく解説していますので、ぜひあわせてご覧ください。
フィジカルAI開発における「強化学習×Sim-to-Real」
仮想空間で強化学習によるAIモデルの開発をおこない、その成果をSim-to-Realで実機へ転移し、実機で得たデータをさらに仮想空間での学習に還元するという流れは、フィジカルAI開発の標準的な進め方になりつつあります。強化学習とSim-to-Realの両者を活用することで、物理世界で実用に耐えるAIを効率よく育てられます。
強化学習に必要な計算リソースと大規模GPU環境の重要性
強化学習×Sim-to-RealによるフィジカルAI開発を進めるためには、計算資源の確保が重要です。以下では、強化学習に求められる計算資源を整理します。
試行錯誤の規模=計算量
強化学習では、精度を高めるために膨大なステップの試行が必要になることも珍しくありません。複雑なプロセスにおける最適な行動を探し当てるためには、とにかく試行回数が重要となります。また、一見単純に見える動作の学習でも、安定した性能に達するまでの試行回数は膨大になりがちです。しかも仮想空間での学習では、物理法則を表現するシミュレーションと、強化学習の学習プロセスとを同時に動かすため、GPUへの負荷は非常に高くなります。並列で動かすシミュレーションの数を増やすほど学習は速く進むため、開発のスピードはGPU基盤の規模に左右されます。
実験サイクルを何度も回すという特性
さらに、強化学習は報酬の設計やハイパーパラメータ※の調整によって結果が大きく変わるため、設定を変えて学習をやり直す「実験サイクル」を何度も回す必要があります。つまり強化学習の基盤には、1回の学習を速く終わらせられる性能と、多くの実験をこなせる環境の両方が求められます。この要件は開発フェーズによっても変化するため、次章ではフェーズに応じた環境の選び方を見ていきます。
※強化学習を進めるにあたって人間が事前に設定する値。具体的には「どの程度新しい行動を試すか」「直近と未来のどちらの報酬を重要視するか」など。
高火力シリーズを用いた強化学習環境の構築
強化学習のために求められる基盤は、検証・大規模学習・推論の段階で異なります。さくらインターネットのGPUクラウド「高火力シリーズ」は、強化学習の各フェーズに適した環境を提供しています。
フェーズで変わる計算リソースの要件
強化学習の開発は、以下3段階のフェーズで進みます。
- 小規模なPoCによるアルゴリズム・報酬設計の検証
- 大規模・並列での本格的な学習
- 学習済みモデルの推論・評価
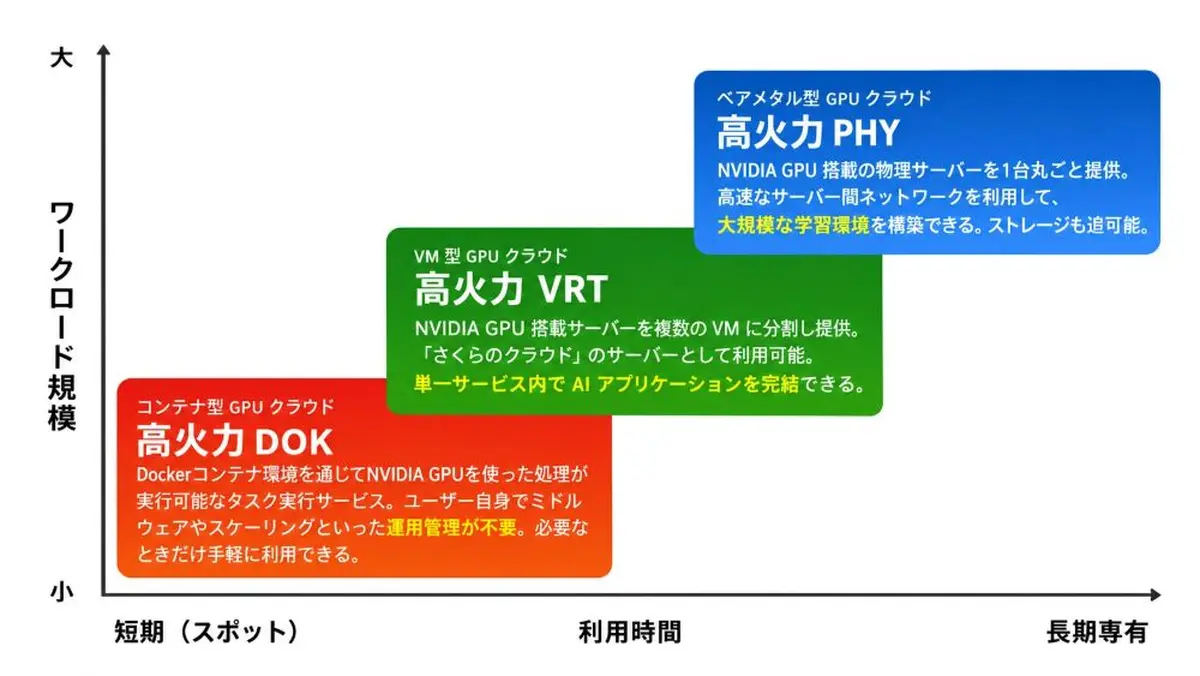
フェーズごとに必要なリソースの性質は異なるため、単一の環境ですべてを賄うのではなく、フェーズに合わせて使い分けることが、コストと開発スピードの両立につながります。たとえば、報酬設計を試す段階で大規模環境を確保するのは過剰投資になりやすく、逆に本格的な学習を小規模な環境でおこなうと時間がかかりすぎてしまいます。
PoC・アルゴリズム検証:高火力 DOK
検証段階では、報酬設計やアルゴリズムの選定を細かく変えながら、小規模な学習を何度も試すことが中心となります。1回あたりの計算量は小さい一方で試行回数が多いため、大規模な環境を常時確保する必要はなく、「思い立ったらすぐ試せる手軽さ」と「使った分だけの低コスト」を備えた基盤が適しています。
そのような用途に適切なのが、さくらインターネットが提供するコンテナ型GPUクラウドサービス 「高火力 DOK」です。「高火力 DOK」は、コンテナ型・秒単位課金のGPUサービスです。報酬設計の検証や小規模なエージェントの学習に手軽に使え、使った分だけの課金で済むため、試行錯誤の初期段階に適しています。
大規模学習:高火力 PHY
本格的な学習段階では、数百〜数千の環境を並列で動かすシミュレーションと学習を、長期間にわたって回し続けることになります。そのため、大容量VRAMを持つGPUを複数束ねた構成、GPU間の高速な接続、そして長時間の連続稼働に耐える安定性が必要です。共有型の環境では性能の変動やリソース確保のしにくさが課題になるため、リソースを専有でき、長期利用でもコストの見通しが立つ基盤が適しています。
さくらインターネットが提供するベアメタル型GPUクラウドサービス 「高火力 PHY」は、NVIDIA H100/H200/B200を8基搭載した物理サーバーを専有できます。数千並列のシミュレーションを伴う大規模な強化学習に適しており、月額固定料金のためコストの見通しも立てやすくなっています。
スポット学習・推論:高火力 VRT
学習済みモデルの評価や推論は、常時大規模なリソースを必要とするわけではなく、「必要なときに、必要な時間だけ」動かす使い方が中心になります。学習と比べればGPU負荷は小さいものの、評価や追加学習は断続的に発生するため、すぐに起動でき、停止すれば課金も止まる柔軟な環境が適しています。
さくらインターネットが提供する VM型GPUクラウドサービス 「高火力 VRT」は、VM型・時間課金のサービスです。学習済みモデルの評価・推論や、追加の学習を必要なときだけ実行する用途に適しています。同社のパブリッククラウド「さくらのクラウド」と組み合わせて、既存システムと連携した構成を取ることも可能です。
まとめ
強化学習は、試行錯誤を通じて行動を学ぶ手法であり、その試行の量がそのまま計算量になります。Sim-to-Realと組み合わせてフィジカルAIを実用化するには、並列シミュレーションと実験サイクルを支える、大規模なGPU基盤が欠かせません。また、PoC・大規模学習・推論というフェーズに応じて基盤を使い分けることで、コストを抑えながら開発スピードを高められます。
さくらインターネットの GPUクラウドサービス 「高火力シリーズ」(DOK/PHY/VRT)は、この使い分けを同じ国内事業者のもとで実現できるラインアップです。強化学習の環境構築を検討されている方は、ぜひサービスサイトをご確認ください。