フィジカルAIとは?開発の課題と基盤選定の考え方を解説
ヒューマノイドロボットの工場導入や自動運転の実用化が進み、AIは「情報を処理する」段階から「物理世界で行動する」段階へと進化しつつあります。政府も「AIロボティクス戦略」において2040年までに1,000万台規模のAIロボットを国内に導入する方針を掲げ、フィジカルAIへの開発投資が本格化しています。※
本記事では、フィジカルAI開発の基盤選定に役立つ視点となるように、フィジカルAIの基本概念と代表例、開発における技術的課題、Sim-to-Real学習を支える計算基盤の考え方、そして基盤選定で押さえたい3つの観点までを整理します。
本記事は、フィジカルAIの開発とそれを支える基盤技術を解説するシリーズ記事の一つです。ほかの記事もあわせてぜひご覧ください。
- フィジカルAIを支える強化学習とは?ロボット制御・自動運転を実現する仕組みと大規模GPUの関係
- 製造業におけるデジタルツイン活用:CAE連動とインフラ要件を解説
- マルチモーダルAIとフィジカルAI:センサーフュージョンの基盤要件
※経済産業省「赤澤経済産業大臣の閣議後記者会見の概要」(2026年6月30日)
- フィジカルAIとは
- フィジカルAIの定義
- 従来のAI・ロボットとの違い
- フィジカルAIの代表例
- なぜいまフィジカルAIが注目されるのか
- フィジカルAI開発における技術的課題
- 大量のセンサーデータ・動画データの処理
- シミュレーション・学習コスト
- 計算資源の確保とデータ主権
- Sim-to-Real学習を実現するために必要な基盤
- Sim-to-Real学習の仕組み
- Sim-to-Real学習のサイクルと3つの計算基盤
- フィジカルAI開発における基盤選定の3つの観点
- データ主権の確保:国内事業者のもとで学習・推論まで完結
- コスト予見性:円建ての請求による予算計画の立てやすさ
- 開発サイクル全体への対応:PoCから現場配備まで対応
- ティアフォー×さくらインターネット
- まとめ
フィジカルAIとは
まずは、「フィジカルAIとは何か」という基本事項から整理していきます。
フィジカルAIの定義
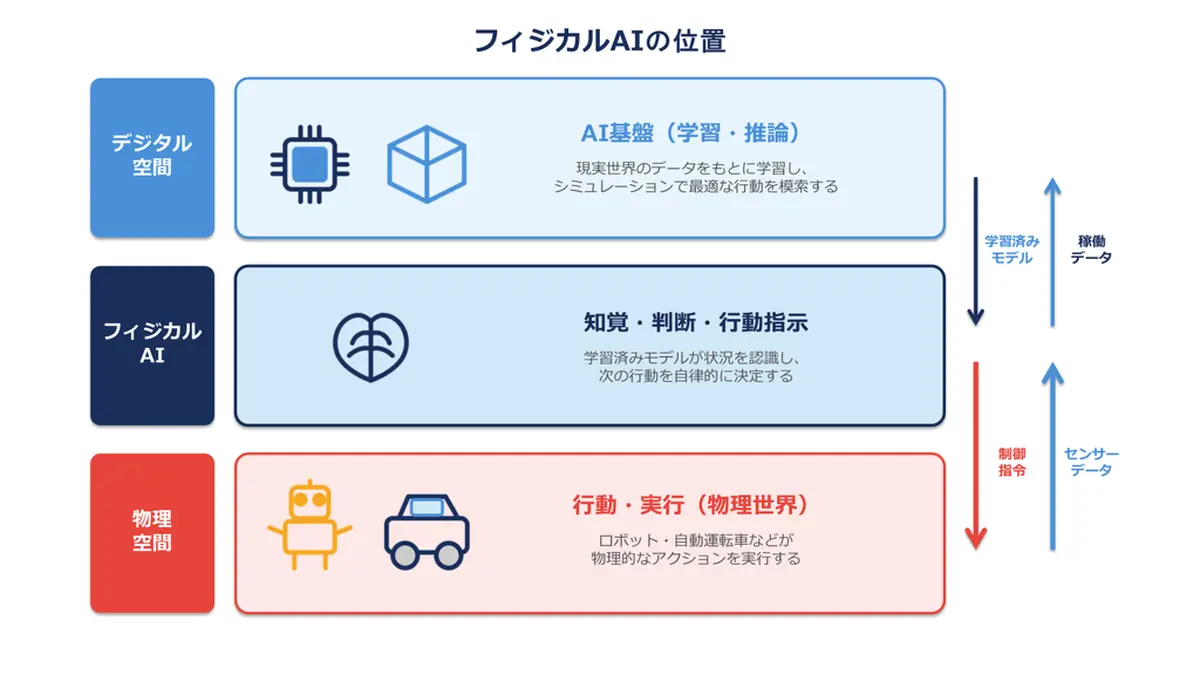
フィジカルAIとは、センサーで現実世界を認識したうえでAIが状況を判断し、ロボットや車両といった物理的なデバイスを通じて現実世界に働きかける仕組みのことです。
たとえば自動運転車では、カメラやLiDAR(レーザー光で周囲との距離を測定し、3次元の点群データとして記録するセンサー)で歩行者や対向車を認識し、AIが減速や車線変更を判断して、ハンドルやブレーキの操作として出力します。AIを活用し、このような「認識→判断→行動」のプロセスを現実世界で実現するのがフィジカルAIです。
従来のAI・ロボットとの違い
ChatGPTに代表される生成AIは、テキストや画像といった情報を入力し、情報を出力するAIであり、処理はデジタル空間で完結します。これに対しフィジカルAIは、出力が現実世界での動作におよびます。物理法則や安全性といった制約を受けながら、リアルタイムに判断し続けることが求められます。
また従来の産業用ロボットは、あらかじめプログラムされた動作を正確に繰り返すことは得意ですが、想定外の状況には対応できない場合もあります。フィジカルAIは、センサー情報をもとにAI自身が状況を解釈し、その場に応じた動作を生成できる点で、従来型ロボットとは異なる技術といえます。
フィジカルAIの代表例
フィジカルAIの代表例としては、以下が挙げられます。
- 工場ラインにおけるヒューマノイドロボット:人と同じ環境・設備のなかで、多品種の作業に柔軟に対応する
- 自動運転・AMR(自律搬送ロボット):公道や倉庫内を自律的に移動し、人や障害物を避けながら目的地に到達する
- AIロボット農業:果実の熟度を見極めた収穫など、非定型な自然環境での作業を自動化する
国内でも、自動運転の公道実証やAIロボット農業などの先進事例が生まれつつあります。
なぜいまフィジカルAIが注目されるのか
おもな背景としては、以下が挙げられます。
- AI技術の進化により、言語指示や周囲の状況を理解する「頭脳」が実用レベルに達したこと
- 仮想空間で学習して実機に転移するSim-to-Real学習が成熟してきたこと
- 日本政府がAIロボティクス戦略を掲げ、国家戦略として社会実装を後押ししていること
- 現場職を中心に人手不足が深刻化し、現場作業の自動化が急務となっていること
技術・政策・社会課題の3方向が追い風となり、フィジカルAIは実用段階へと進みつつあります。
フィジカルAI開発における技術的課題
フィジカルAIの開発には、従来のAI開発とは質も量も異なる計算資源とデータ管理が求められます。ここでは代表的な3つの課題を整理します。
大量のセンサーデータ・動画データの処理
ロボットや車両を動かすAIモデルの学習には、カメラ映像やLiDARで取得した点群データなど、現場で収集した大量のセンサーデータを処理する必要があります。高解像度の動画や3次元点群は、テキストと比べて1件あたりのデータ量が桁違いに大きく、たとえば自動運転の実証車両では、1台が1日走行するだけでテラバイト級のデータが発生するといわれています。※
こうしたデータを前処理し、繰り返し学習にかけるためには、大容量ストレージと大規模なGPUサーバーが不可欠です。
※燃料はデータ、エンジンはAI:自動運転競争の新ルール( KPMGジャパンウェブサイト)
シミュレーション・学習コスト
実機による試行錯誤には、機体の破損リスクや安全確保、時間的コストといった制約がともないます。そこで、フィジカルAIの実現においては現実世界を模した仮想空間で学習し、その成果を実機に転移する「Sim-to-Real学習」と呼ばれる手法が主流となっています。
Sim-to-Real学習によるアプローチは実機での試行錯誤と比べれば効率的ですが、物理法則を忠実に再現するシミュレーション環境の構築・実行にも高い計算コストがかかります。
計算資源の確保とデータ主権
世界的なAI需要の高まりから最新GPUは慢性的に不足しており、学習に必要な計算資源の確保は容易ではありません。加えて、走行データや工場内の映像といった機密性の高いデータを海外クラウドに送ることへの懸念、いわゆる「データ主権」の問題も高まっています。国内で完結して大規模学習をおこなえる基盤への需要は、今後ますます強まると考えられます。
Sim-to-Real学習を実現するために必要な基盤
こうした課題に対応するには、Sim-to-Real学習のサイクルを効率よく支える計算基盤の整備が鍵となります。
Sim-to-Real学習の仕組み
前述のとおり、Sim-to-Real学習は仮想環境(Simulation)で学習したAIを現実(Real)の機器へ適用する手法です。仮想空間であれば、悪天候や衝突寸前の状況といった、現実では再現が難しい条件も安全に、何万回でも試行できます。Sim-to-Real学習では、仮想空間で学習した結果をベースとしつつ、仮想と現実のギャップを補正しながら、実環境での動作精度を高めていきます。
Sim-to-Real学習のサイクルと3つの計算基盤
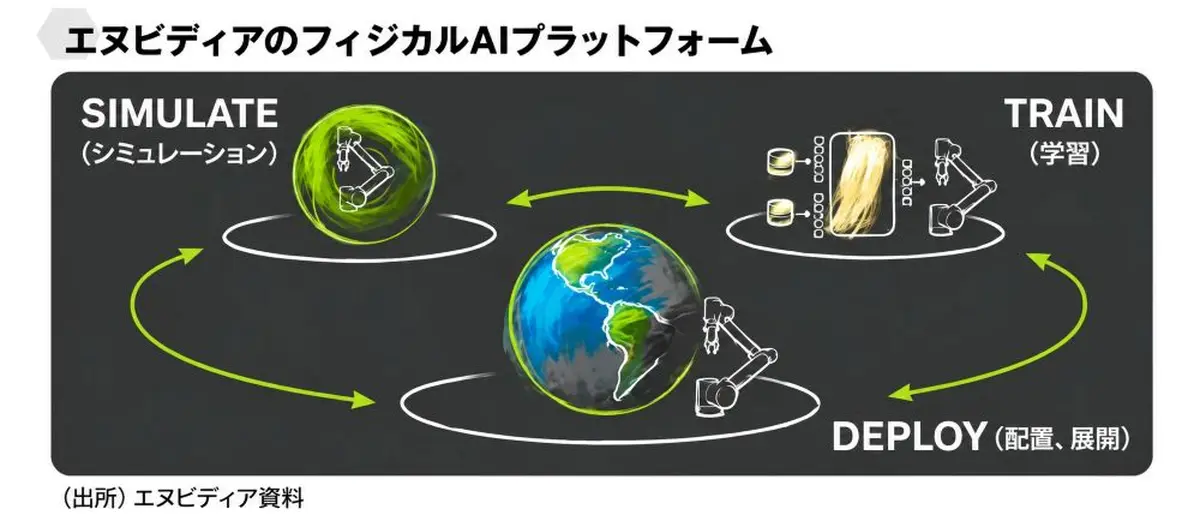
Sim-to-RealによるフィジカルAIの開発は、以下のサイクルを回し続ける営みです。
- 世界基盤モデル(物理世界の状態や変化を学習・予測するAIモデル)やデジタルツインを用いたシミュレーション・合成データ生成
- データセンターでの大規模学習
- 実機での推論・行動
- 実稼働データを回収して再び学習へ
たとえば、倉庫の搬送ロボットを開発する場合を考えてみましょう。
- 仮想空間に倉庫を再現し、棚の配置や人の動き、照明条件などを変えながら走行データを大量に生成します。
- 生成した大量のデータをデータセンターのGPUクラスターに集約し、走行や停止判断を担うAIモデルを学習させます。
- 学習済みモデルは実機に搭載され、現場でリアルタイムに推論しながら自律走行します。
- 実際の現場で得られた「想定外の障害物への反応」や「人とのすれ違い」などの稼働データを回収し、次のシミュレーションと学習に反映します。
これら1〜4のサイクルを繰り返すことで、ロボットは現場環境に適応しながら賢くなっていきます。
この流れを支えるのが、「学習用」「シミュレーション用」「実機推論用」という3種類の計算基盤であり、NVIDIA社はこれを「3つのコンピューター」と呼んでいます※。フェーズごとに求められる計算資源の性質は異なるため、開発の進み方に合わせて基盤を使い分ける視点が重要です。
※3台のコンピューターによるソリューション: AI ロボットの次の波を推進(NVIDIA社ウェブサイト)
フィジカルAI開発における基盤選定の3つの観点
大量の機密データを扱いながら学習サイクルを回し続けるフィジカルAI開発では、「どこにある、誰が運営する基盤を使うか」も重要な選定軸となります。ここでは、データ主権の確保・コスト予見性・開発サイクル全体への対応という3つの観点を整理します。
データ主権の確保:国内事業者のもとで学習・推論まで完結
フィジカルAIの学習データには、走行データや工場内の映像・音声など、事業競争力に直結する機密情報が含まれます。クラウド基盤を選定する際は、国内リージョンの有無だけでなく、データの保管場所、管理主体、適用法、越境移転の条件などを確認することが重要です。
国産事業者が国内のデータセンターで運営する基盤であれば、データの保管から学習・推論までを国内で完結でき、社内のガバナンスや監査への説明においても利点があります。
コスト予見性:円建ての請求による予算計画の立てやすさ
外貨建て・従量課金型のクラウドサービスは、利用量の増加に加えて為替変動によっても実質的なコストが変動し、想定外のコスト増を招くリスクがあります。学習サイクルを何度も回すフィジカルAI開発では利用額そのものが大きくなるため、円建てで費用を把握できるサービスであれば、為替変動の影響を抑え、予算計画を立てやすくなる場合があります。
開発サイクル全体への対応:PoCから現場配備まで対応
データを国内に保持したまま、開発のフェーズ間で基盤を移行でき、契約やサポートの窓口を一本化できることは、開発スピードとガバナンスの両面でメリットとなります。
さくらインターネットの高火力シリーズをご利用いただくと、PoC・小規模検証はコンテナ型・秒課金の「高火力 DOK」、大規模学習はベアメタル専有型の「高火力 PHY」、推論・スポット学習は VM型・時間課金の「高火力 VRT」というように、開発サイクルの各フェーズを同じ国産事業者で対応できます。さらに、高火力シリーズはさくらインターネットが国内で運営するデータセンターで運用され、円建ての料金体系で利用できるため、これまでに挙げたデータ主権・コスト予見性を重視する場合の選択肢の一つとなります。
ティアフォー×さくらインターネット
株式会社ティアフォーは、「自動運転の民主化」をビジョンに掲げ、オープンソースの自動運転OS「Autoware」の開発を主導しています。さらに自動運転開発を効率的にサポートする「Co-MLOpsプラットフォーム」の開発もおこない、その基盤にさくらインターネットの「高火力 PHY」を採用しています。
同社では、高火力 PHYの活用により、巨大な学習モデルを利用した実験の期間が、従来の2〜3週間から1週間以内に短縮されました。これによって余力のできたGPUリソースを、モデル探索やハイパーパラメータチューニングに投入し、さらなるモデル精度の向上を進めています。
自動運転AIの開発では、車両に搭載したカメラやLiDARなどのセンサーから収集される膨大な走行データを使い、モデルの学習と検証を何度も繰り返す必要があります。まさに「桁違いのデータ量」と「学習サイクルの高速化」という課題に直面した事例といえるでしょう。
※出典:日経クロステック 「ティアフォーの「自動運転の民主化」を後押しするさくらの高火力GPUクラウドサービス」
まとめ
フィジカルAIは、「情報処理」から「物理世界での行動」へと向かうAIの次の進化です。その開発には、大量のセンサーデータ処理とSim-to-Real学習という、従来とは桁違いの計算需要を要します。開発・運用に必要となるスペックはフェーズごとに異なり、用途に合わせた適切な選定が求められます。また、その際にはデータ主権・コスト予見性・開発サイクル全体をカバーできる体制という観点からの基盤選定が、プロジェクトの成否を左右します。
さくらインターネットは、大規模学習向けの専有GPUサーバー「高火力 PHY」から、推論やスポット学習に適した「高火力 VRT」まで、国内完結のGPU基盤を提供しています。フィジカルAIの開発基盤を検討されている方は、ぜひサービスサイトをご確認ください。