VRAMとは?AI開発における役割とRAMとの違い、必要容量の目安を解説
AI開発に使うGPUの選定では、演算性能に目が行きがちです。しかし用途によっては、モデルやデータを載せきれるかどうか、つまりVRAM(GPUメモリー)の容量が制約になることも多く、VRAMは演算性能と並ぶ重要な選定基準です。とくに生成AIはVRAMを大量に消費し、容量が足りなければ学習も推論もそもそも実行できません。
本記事では、VRAMの役割とシステムメモリー(RAM)との違い、AI開発における必要容量の目安、VRAM不足が引き起こすボトルネックとその対処、そしてGPUクラウドを活用した効率的な環境構築までを解説します。
VRAMとは
まずは、VRAMがどのような部品で、なぜAI開発で重要になるのかを整理します。
VRAMの役割
VRAM(Video RAM)とは、GPUに直結された専用メモリーのことです。AI開発では、モデルのパラメータ、処理対象のデータ、計算の中間結果などを保持するために使われます。VRAMはいわば「GPUの作業机」のようなものであり、机が狭ければ大きな仕事は広げられません。
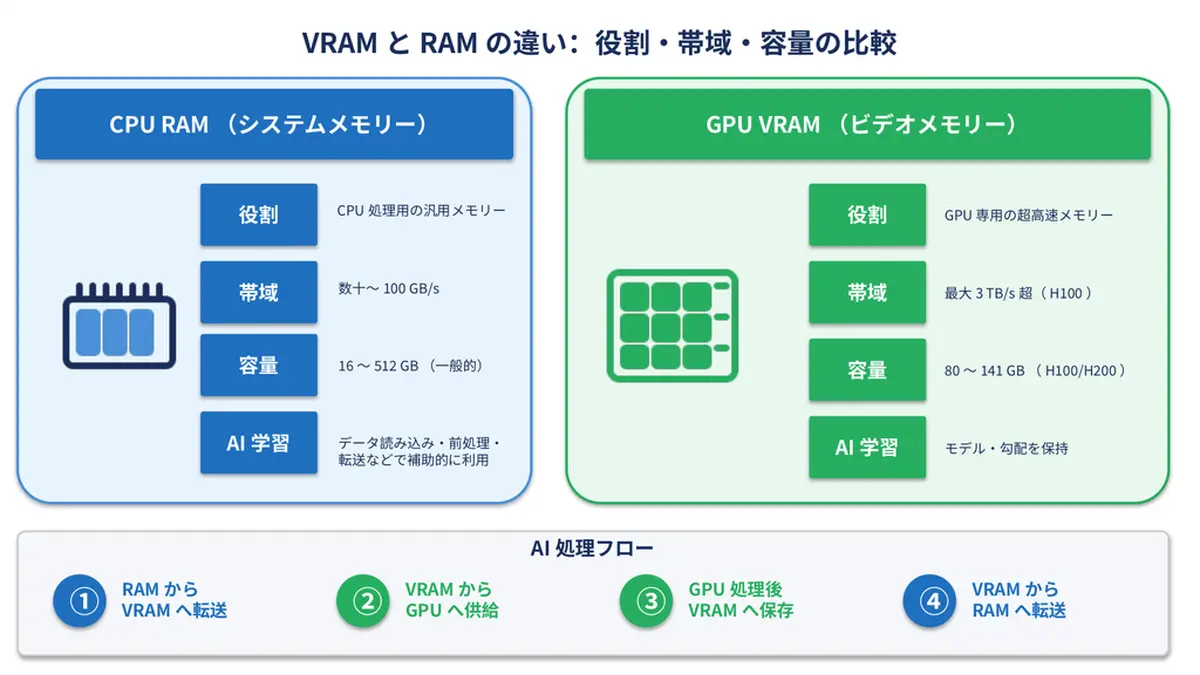
GPUは数千のコアで並列計算をおこなうため、その処理を止めないように各コアへデータを超高速に供給し続ける必要があります。VRAMはコアにデータを転送する役割を担い、その性能は、大きく「容量」と「帯域」で判断できます。VRAMの容量は「どれだけ大きなモデル・データを扱えるか」を、帯域は「どれだけ速くデータを供給できるか」を決め、GPUの性能を引き出せるかどうかを左右します。
システムメモリー(RAM)との違い
PCのスペック表などで目にすることが多いRAMはCPUが使う汎用メモリーであり、OSやアプリケーションなど幅広い処理を支えます。一方VRAMは、GPUでの並列計算に特化した高帯域のメモリーです。近年のAI向けGPUではHBMと呼ばれる広帯域メモリーが採用されており、その帯域はRAMの数十倍に達します。たとえばNVIDIA H100 SXMが搭載するHBMの帯域は毎秒3TB超に達し、一般的なサーバー用RAMとは桁が異なります。
用途と性能が異なるため、VRAMが不足してもRAMで単純に肩代わりすることはできません。あふれたデータをRAMに退避させる方法もありますが、データ転送が遅いため、処理性能は大きく低下します。
AI開発における必要VRAM容量の目安
では、実際にどれくらいのVRAM容量が必要なのでしょうか。LLMを例に、見積もりの考え方と用途別の目安を整理します。
必要VRAM容量の考え方
LLMの推論に必要なVRAMは、おおまかに以下3つの合計で見積もれます。
①モデルのパラメータ数×2バイト(※1)
②KVキャッシュ(※2)
③一時的に利用される作業領域」
たとえば7B(70億パラメータ)モデルなら、FP16でパラメータ分だけで約14GBを消費し、これにKVキャッシュと作業領域が加わるため、実際には16GB以上が目安になります。なお、①は「量子化」と呼ばれる手法でパラメータの表現を圧縮することで、必要量を1/2〜1/4程度に抑えられます
一方、学習フェーズでは、パラメータに加えて勾配(※3)やオプティマイザー(※4)の状態も保持する必要があるため、同じ規模のモデルでも推論の数倍のVRAMが必要になります。
※1 FP16(16ビットの半精度浮動小数点数)を扱う場合
※2 Key-Valueキャッシュの略であり、それまでの計算結果を保持するための領域
※3 ニューラルネットの学習において、予測誤差を減らすためにパラメータをどの方向へ調整すべきかを示す値
※4 勾配をもとにして、パラメータを更新するための最適化アルゴリズム。最適化のために過去の状態も含めて情報を保管するため、VRAM消費量が大きくなりやすい
用途別の目安表
代表的な用途ごとの必要VRAM容量の目安は、次の表のとおりです。量子化の有無によっても必要量が大きく変わるため、両方のケースを併記しています。モデルの構成やバッチサイズ、手法などによって実際の必要量は変動します。あくまで初期サイジングの目安としてご利用ください。
| 用途 | モデル規模の例 | FP16利用時の目安 | 量子化(4bit)利用時の目安 |
|---|---|---|---|
| LLM推論 | 7Bクラス | 約16GB〜 | 約6GB〜 |
| LLM推論 | 13Bクラス | 約32GB〜 | 約8GB〜 |
| LLM推論 | 70Bクラス | 約140GB〜 | 約48GB〜 |
| ファインチューニング(LoRA※) | 13Bクラス | 約32GB〜 | 約24GB〜 |
| ファインチューニング(フル学習) | 13Bクラス | 約240GB~ |
※モデルの一部パラメータのみを追加で更新することで、効率的にファインチューニングを行う手法のこと
GPUモデル別のVRAM搭載量
必要量の目安がつかめたら、GPUごとのVRAM搭載量と突き合わせます。AI向けGPUの代表的なモデルでは、NVIDIA V100が32GB、H100が80GB、H200が141GB、B200が192GBのVRAMを搭載しています※。たとえば、13BクラスのLLMをFP16で推論するならV100またはH100クラス、70BクラスであればH200/B200クラスでマルチGPU構成が視野に入る、といった対応づけができます。
※それぞれの値は代表的なモデルのものです。モデルにより、搭載されているVRAMは異なります。
VRAM不足が引き起こす開発の停滞とボトルネック
VRAMの見積もりを誤ると、開発現場では何が起きるのでしょうか。
VRAM不足の典型的な症状
もっともわかりやすいのは、「Out of Memory」エラーによる処理の中断です。学習が途中で止まるほか、エラーを避けるためにバッチサイズを小さくすれば学習速度や精度に影響が出ます。一方でモデルの規模自体を削れば、精度の悪化に直結します。また、VRAM容量がぎりぎりの構成で運用すると、長い入力や高解像度データなどわずかな条件の変化でエラーが再発し、安定した運用が難しくなります。
VRAM不足への対処テクニックは、以下の記事でくわしく解説していますので、あわせてご覧ください。
VRAMは後から増やせない
システムメモリーと異なり、VRAMはGPUと一体で実装されており、後から増設できません。オンプレミスでGPUを購入した場合、VRAM不足が判明しても買い替える以外の選択肢がなく、大きな投資リスクになります。さらに、AIモデルの大型化は年々進んでいます。購入時点では十分に見えたサイジングが、扱うモデルの世代交代によって短期間で不足に転じる可能性も考慮しなければなりません。
GPU環境構築の効率化とGPUクラウドのメリット
「あとからではVRAM容量を増やせない」問題への解決策が、GPUクラウドの活用です。
GPUクラウドなら用途に合わせてVRAMを選べる
GPUクラウドであれば、プロジェクトやフェーズごとに最適なVRAM容量のGPUを選び直せます。検証段階は小さめのVRAM、本番は大容量VRAMといった使い分けができるのがメリットです。たとえば、開発初期は小さめのVRAMのGPUで検証し、モデルの大型化に合わせてH100(80GB)へ切り替える、といった段階的なスケールも容易です。
時間課金でコストを最適化する
VM型のGPUクラウドなら時間単位で利用でき、使わない時間は停止して課金を止められます。たとえばさくらインターネットの VM型GPUクラウドサービス 「高火力 VRT」は、H100(80GB)などのGPUを時間課金で利用できます。初期投資を抑えながら、必要なVRAM容量を必要な期間だけ確保できます。
より大きなVRAMが必要な場合
70BクラスのLLMのフル学習など、単一GPUのVRAMに収まらないワークロードでは、複数のGPUでVRAMを束ねる構成が必要になります。その場合は、NVIDIA B200 Tensor コア GPUを8基搭載した、さくらインターネットのベアメタル型GPUクラウドサービス 「高火力 PHY」が選択肢になります※。たとえばH200を8基搭載したモデルであれば、1台で合計1TBを超えるVRAMを利用でき、大規模モデルのフル学習にも対応できます。
※プランにより、搭載されるGPUは異なります。
まとめ
VRAMは、AI開発の成否を左右する重要なリソースです。不足すると、RAMへの退避などで処理速度が大きく低下したり、そもそもモデルを動かせなかったり、開発の停滞を招きます。まずは用途別の目安で必要容量を見積もり、そのうえでGPUクラウドで柔軟に確保するアプローチが現実的です。
さくらインターネットが国内データセンターで提供するGPUサーバーのクラウドサービス 「高火力」シリーズなら、時間課金でGPU・VRAM容量を選べる「高火力 VRT」から、大容量VRAMを備えたGPUを束ねて利用できる「高火力 PHY」まで、用途に応じた環境を利用できます。GPU環境の構築を検討されている方は、ぜひサービスサイトをご確認ください。