企業の内部データを安全に活用するAI基盤「KumaKumaAI」を使ってみた
社内のどこかに必ずある、あの資料。「昨年作成した提案書、誰のフォルダだっけ」「同じ問い合わせに以前も対応したはずなのに、記録が見つからない」──。
こうした「探す時間」に、企業は想像以上のコストを費やしています。
本記事では、企業に蓄積されたデータを安全かつ効率的に活用するためのAIエージェント
「KumaKumaAI(クマクマAI)」を、実際の画面とともに紹介します。
KumaKumaAIとは?
KumaKumaAIは、株式会社Grizzlarityが開発する Enterprise Deep Research Agent(企業向けの深層検索AIエージェント)です。コンセプトはシンプルで、こう掲げられています。
溜まったデータを利活用して、自社業務をリデザイン。
企業の膨大な社内文書から必要な情報を瞬時に検索し、従来のキーワード検索を超えた「複数の情報を踏まえた回答」を返してくれる ──。 それがこのサービスの核です。
ポイントは、ただの検索ツールではなく、マルチエージェントシステムを採用していることです。
複数のAIエージェントがそれぞれ役割を分担し、調査計画を立てながら情報を集めます。必要に応じて追加調査や再検索を繰り返し、回答精度を高めていきます。
一般的なRAG検索と何が違う?
社内文書を検索するAIというと、いわゆる「RAG」を思い浮かべる方も多いと思います。一般的なRAGでは、ドキュメントを分割してベクトル化し、質問に近い情報を引っ張ってくる構成がよく使われます。
それに対してKumaKumaAIの特徴は、ナレッジベースをベクトルストアとして扱うのではない点にあります。N-gram方式の全文検索をエージェントがツールとして用い、人間が資料を探すときのように、キーワードの変更や言い換えを繰り返しながら、探索的に調査を進めます。ユーザーの要求をもとにまず調査計画を立て、以下のタスクを、それぞれ専門のエージェントが担当します。
- ナレッジベース検索
- Web検索
- Google Drive / Slack / OneDrive などの連携サービス検索
全体を統括するSupervisor(スーパーバイザー)が各エージェントにタスクを割り当て、得られた結果を評価します。
情報が足りなければさらに掘り下げます。この「深掘り」の繰り返しが、複雑な質問への回答精度を支えています。
「データを外に出さない」という安心感
エンタープライズでAIを使ううえで、多くの企業が最後まで気にするのが「機密データの扱い」です。
KumaKumaAIは、機密データの安全な取り扱いを製品の前提として設計しています。サービスサイトでも明確に打ち出されているのが次の2点です。
- オンプレミス対応可
- 入力データは学習に使いません
さらに同社は、機密データを外部に持ち出さず、LLMによる推論を含めて国内環境で完結させる構成にも取り組んでいます。たとえば、推論を含む主要処理を国内データセンター内で完結できる基盤には、さくらインターネットのVM型GPUクラウドサービス「高火力 VRT」が採用されています。
>> 機密データを外に出さない――Grizzlarityが「高火力 VRT」で実現した「国内完結」のマルチエージェントAI
データの保管場所や処理経路を顧客に明確に説明できることは、生成AIサービスに求められる説明責任を果たすうえで役立ちます。
開発元:株式会社Grizzlarityについて
KumaKumaAI を手がけるのは、株式会社Grizzlarity(グリズラリティ)です。
- 事業内容:AIインテグレーション事業 / 業界特化型マルチエージェントAIプラットフォーム「KumaKumaAI」/ マルチエージェントAIシステムの研究開発
- 設立:2025年8月
- 代表者:CEO 藤田 智也 氏
- URL:https://grizzlarity.com/
「AIとデータで未来を創る」を掲げ、機械学習・データサイエンス・システム開発の専門知識で企業のDXを支援する会社です。
LPのフッターには「Made in Tokyo」の文字があります。国内発のAIサービスとして、企業の大切なナレッジを安全に守りながら、必要な情報へすばやくたどり着けるAIを広げていく方針が示されています。
ちなみに社名は北米の熊である「グリズリー」から来ているそうです。熊つながりですね!
実際に使ってみる
ここからは、実際の画面を見ながら主要な機能を確認します。
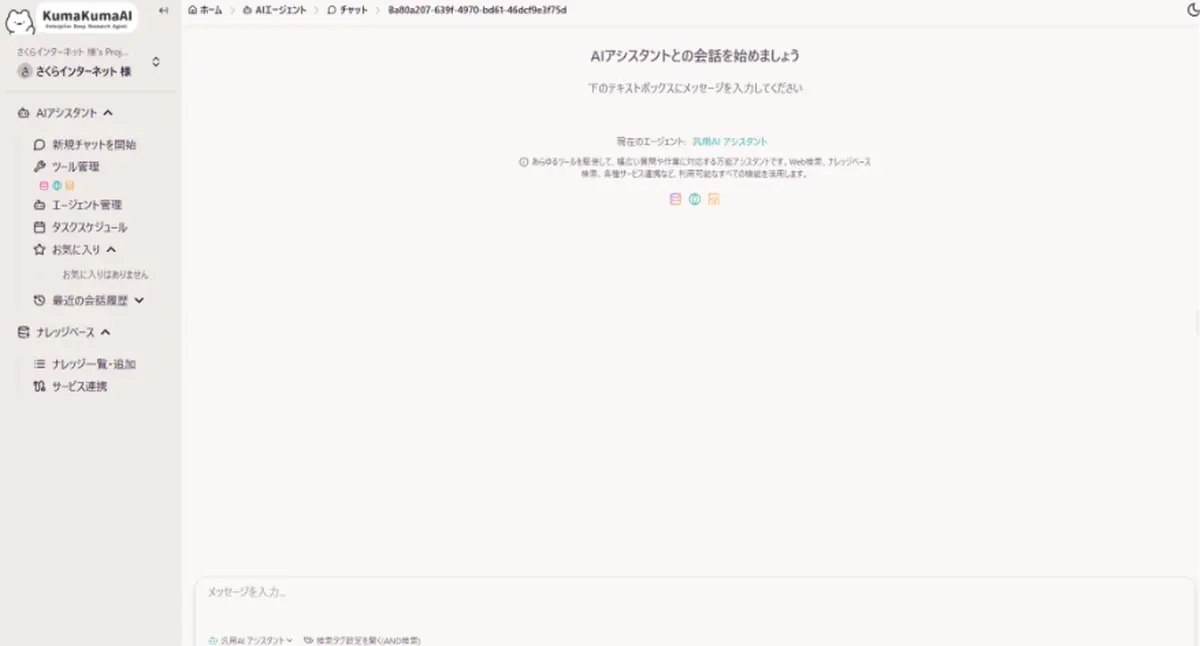
ログイン後の画面には、汎用AIアシスタントとのチャット画面が表示されます。
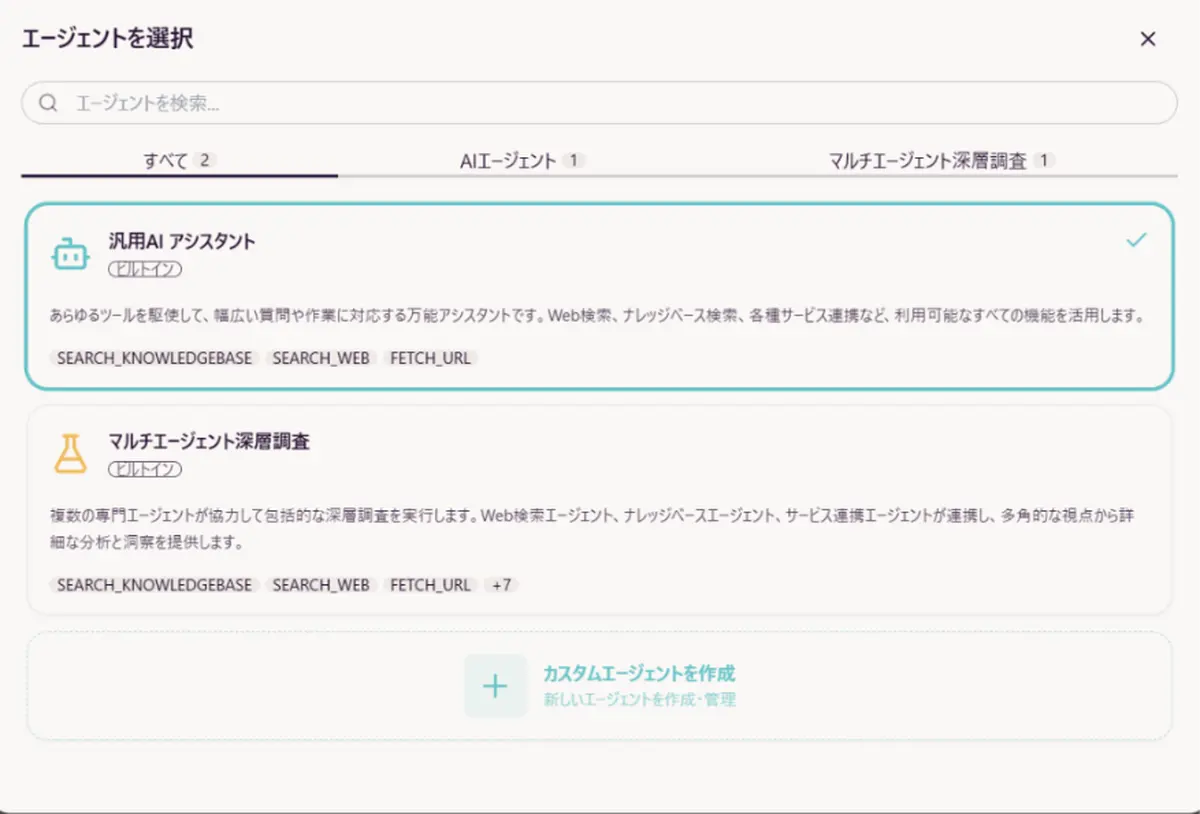
ビルトインの機能として、汎用AIアシスタントのほか、より詳細な回答を得るための「マルチエージェント深層調査」が用意されています。
次に、汎用AIアシスタントへ実際に質問してみます。
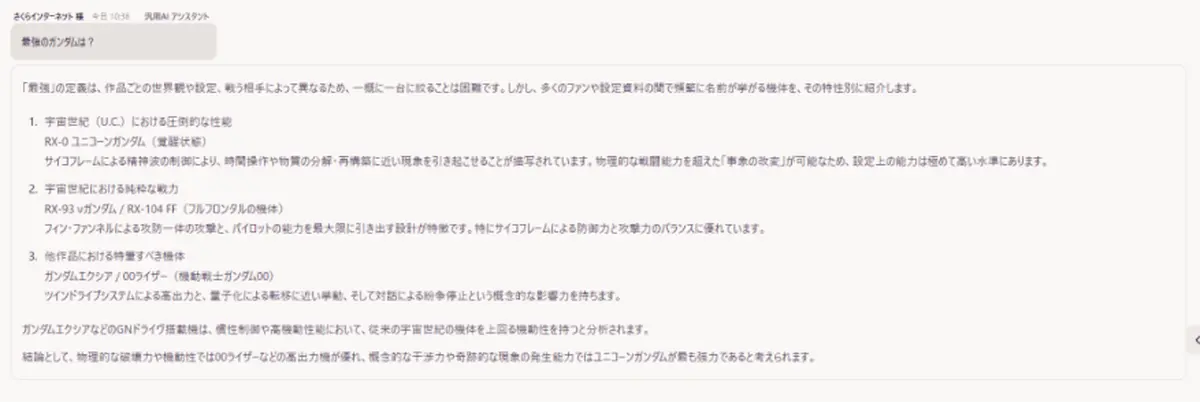
使用モデルとツール/Web Search
KumaKumaAIは、さくらインターネットの「高火力 VRT」上で動作しており、モデルにはGoogleが提供するオープンモデルGemma4 を使用しています。
ローカルLLMは近年進歩が著しく、以前と比べて性能が大きく向上しています。
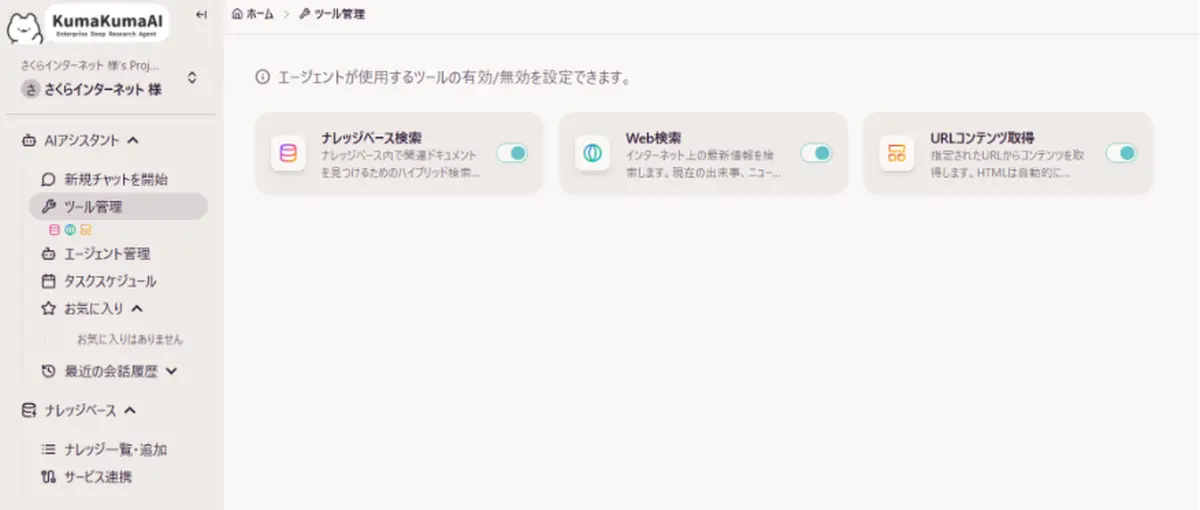
一方で、AnthropicやOpenAIの最新モデルと比べた場合、導入時の課題になりやすいのがWeb Searchです。
ローカルモデルには、未知の情報を自ら検索してまとめる機能が標準では備わっていません。そのため独自に実装する必要がありますが、KumaKumaAIでは「ツール」機能として提供されています。
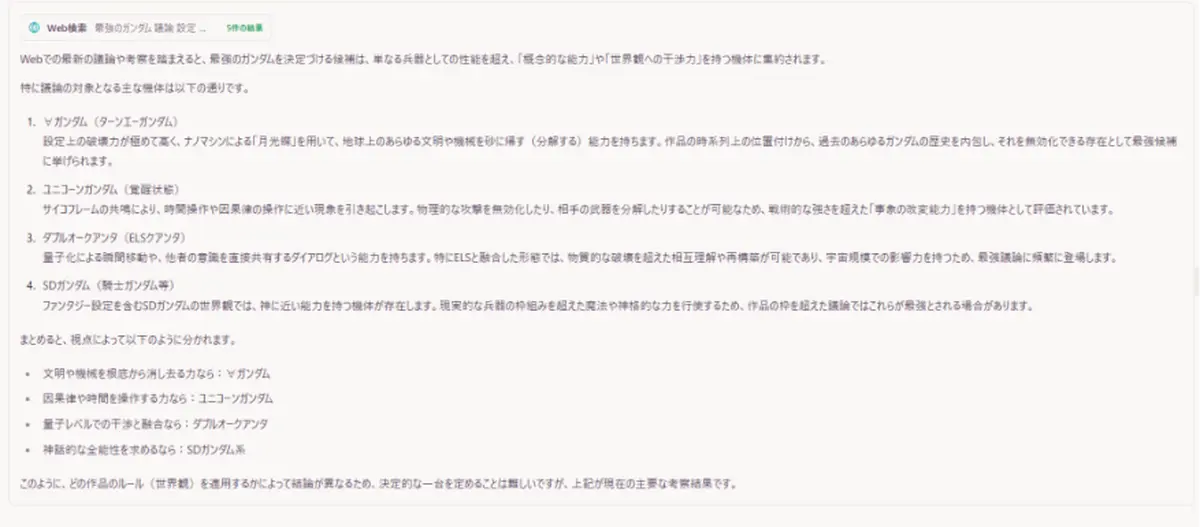
さきほどのチャットには、一部のガンダムファンには許容しにくい回答が含まれていました。Web検索をおこなうことで、回答が次のように補正されます。
ナレッジベース
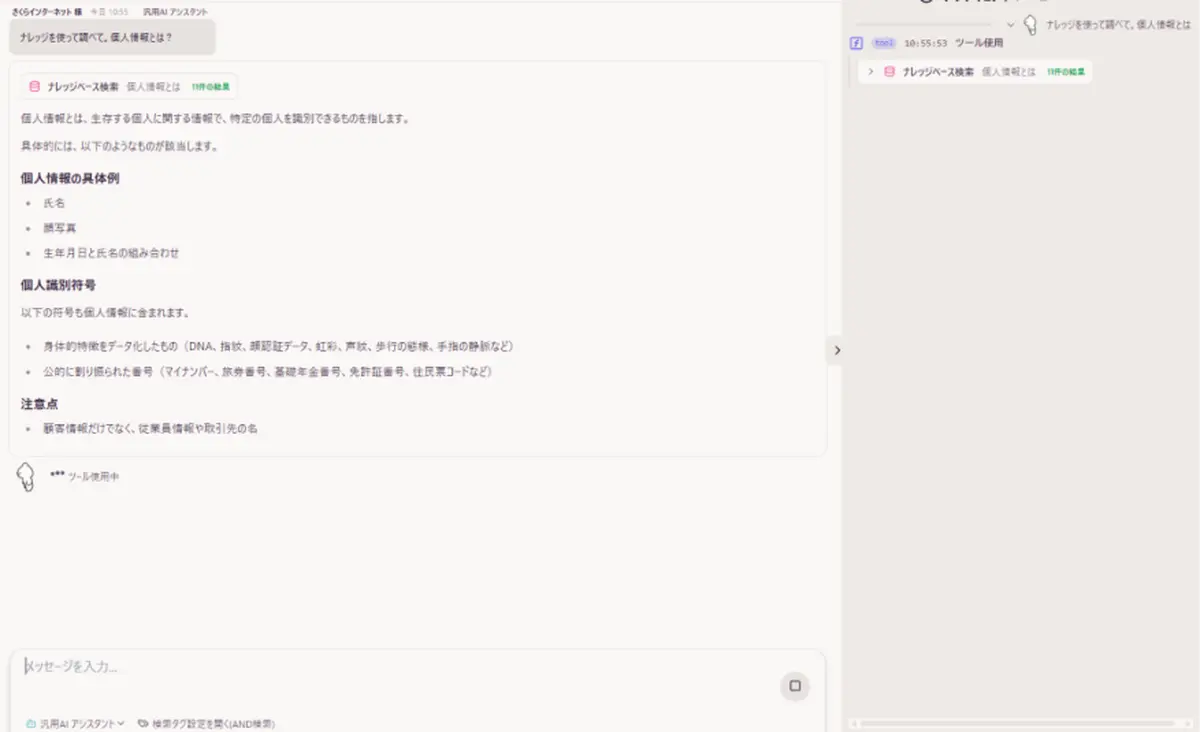
ベクトルストアでさまざまな非構造化文書を検索対象とするRAGを構築するためのナレッジベースも、機能として提供されています。統合版のKumaKumaAIでは、ベクトル検索ではなくN-gram方式の全文検索を用い、エージェントが広めのキーワードで検索した結果を評価しながら、同義語・言い換え・日本語と英語の切り替えなどを自律的に試して目的の情報にたどり着きます。
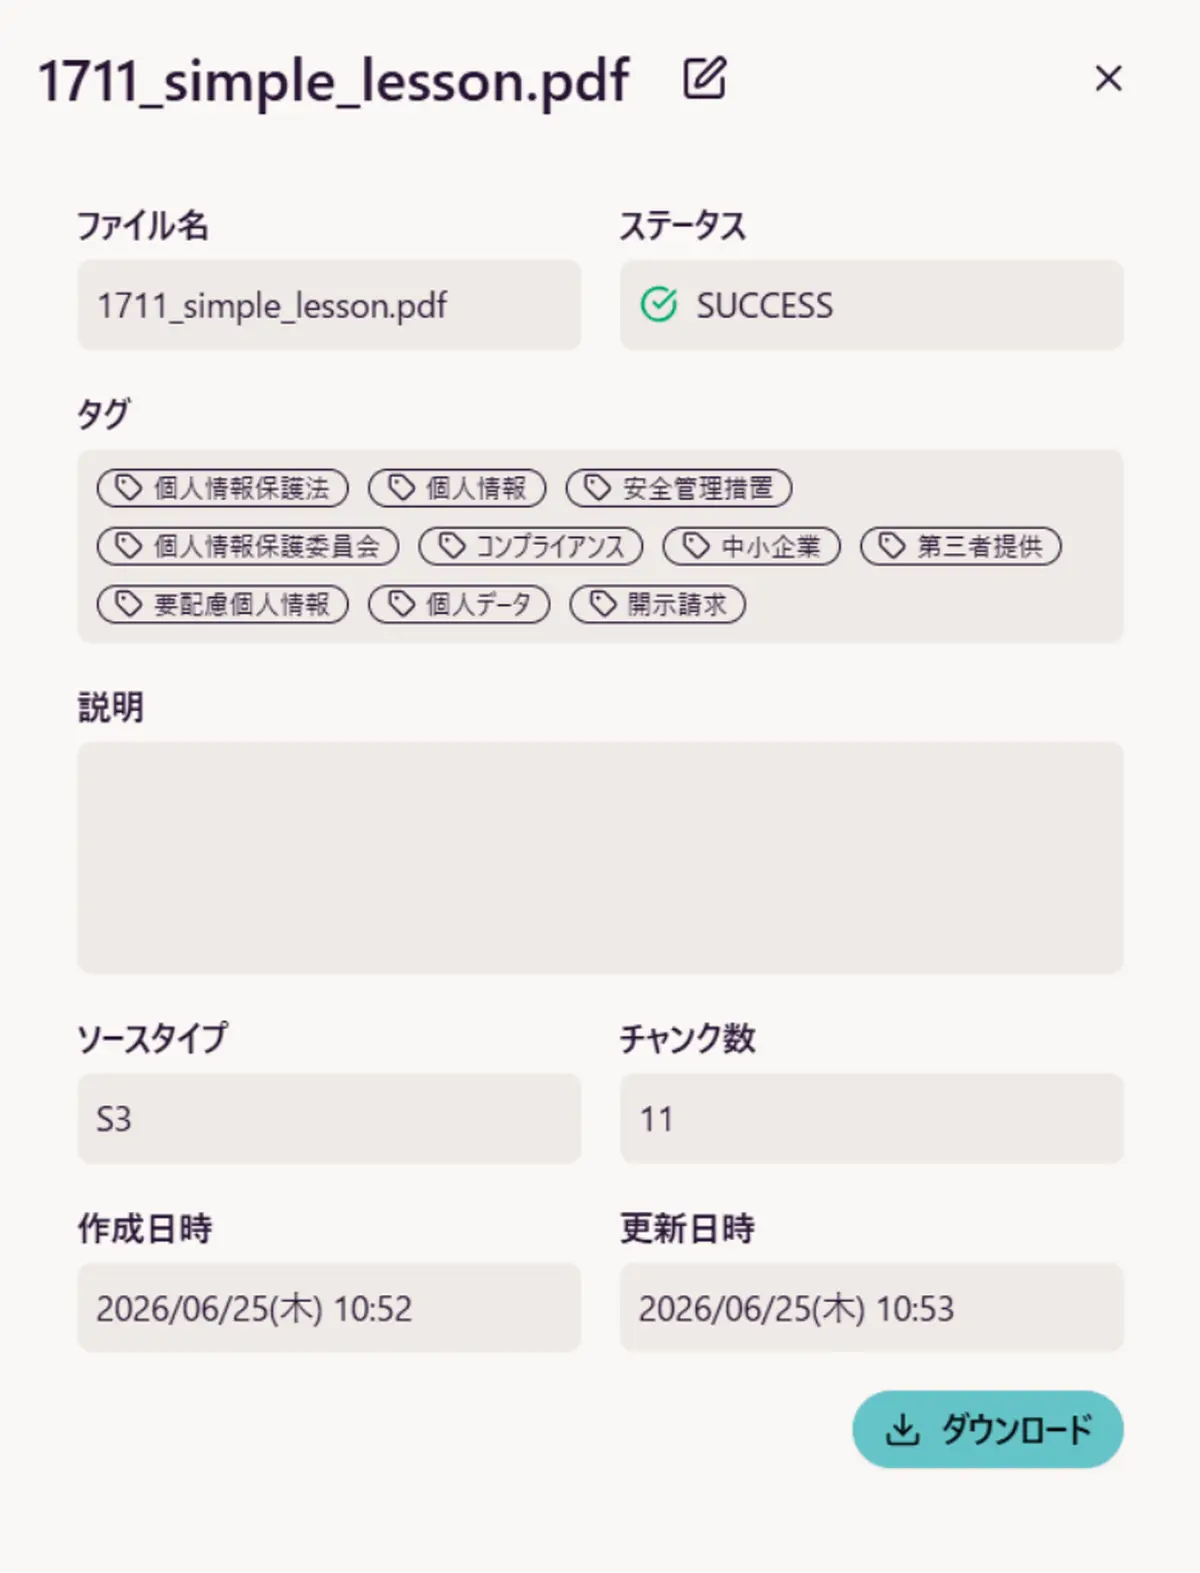
たとえば、個人情報に関するPDFを登録すると、データの取り込みが開始されます。
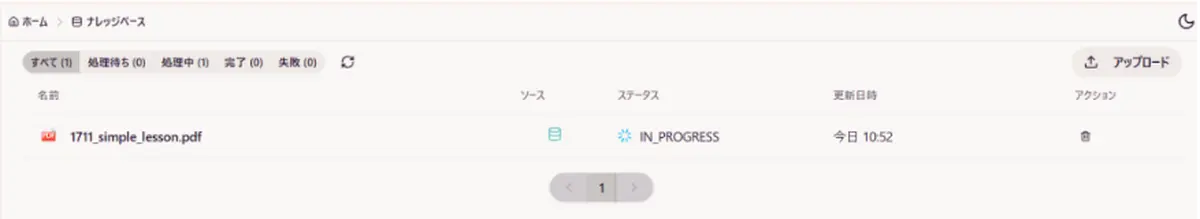
チャンク分割やタグの付与は自動でおこなわれるため、専門的な設定を意識せずにナレッジを作成しやすくなっています。
ナレッジの作成後は、次のように検索できます。
KumaKumaAIが向いている企業・活用シーン・導入時のポイント
KumaKumaAIの使い方はイメージできたでしょうか。
KumaKumaAIは、社内に散在する文書やナレッジをAIで横断活用したい企業や、機密データを外部に持ち出さずに生成AIを活用したい企業に向いています。とくに製造業、金融、公共、士業など、情報管理を重視する組織との相性が良いでしょう。活用シーンとしては、問い合わせ対応、営業資料や技術文書の検索、社内ナレッジ共有、メール返信支援などが挙げられます。複数のAIエージェントが調査・再検索を繰り返すため、複雑な質問への対応にも強みがあります。
導入を検討する際は、回答精度だけでなく、データの保管場所や処理環境も重要なポイントです。Grizzlarityでは、国内データセンター上でLLM推論まで完結する構成にも取り組んでおり、セキュリティーやガバナンスを重視する企業のニーズに応えています。こうした取り組みの詳細については、「機密データを外に出さない――Grizzlarityが『高火力 VRT』で実現した『国内完結』のマルチエージェントAI」もぜひ参考にしてください。